

文档去手写V2
更新时间:2026-09-18
接口描述
文档去手写V2公测上线,欢迎体验!
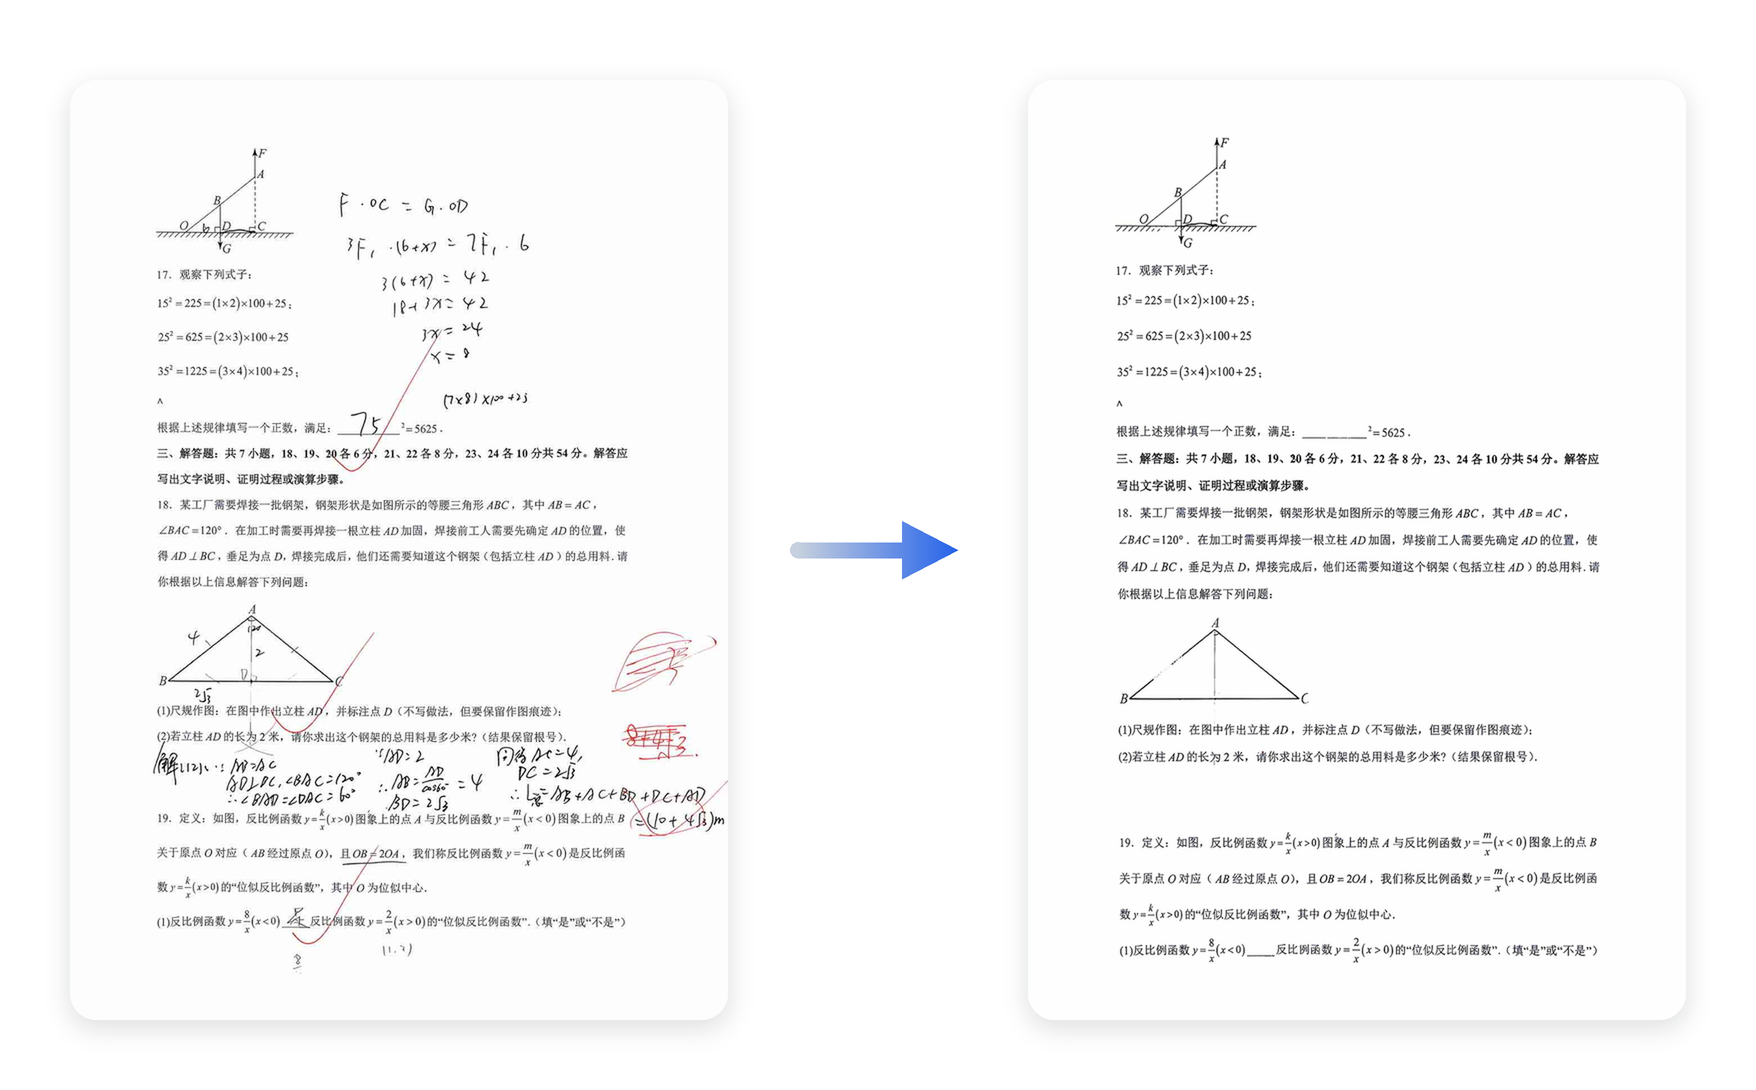
用于去除图片中的手写内容并保留印刷体内容;V2版本采用更精细的版面分析,可精准识别并去除涂改、批注、笔记等手写痕迹,去除后印刷体笔画与版式完整保留,适用于试卷、文档、手稿、票据等场景的去手写还原与归档扫描。
V2主要提升
- 新增方向转正参数
enable_ori:适用于拍摄角度不正的场景,例如文档被横拍、倒置或旋转了一定角度,开启后自动识别并还原正确朝向,无需手动调整。 - 去除更彻底:无论是浅淡笔迹还是多种颜色的手写内容,都能更干净地清除,不留残影,视觉效果更整洁。
- 印刷内容更完整:去手写的同时对原文档"无损",文字、表格、线条、公式均完整保留。
- 画面更自然:处理后的区域与周围内容融合更自然,无明显色块或噪点,阅读体验流畅。
公测期间可获取免费测试额度
- 个人实名:免费测试资源 500 次
- 企业实名:免费测试资源 1000 次
在线调试
您可以在 示例代码中心 中调试该接口,可进行签名验证、查看在线调用的请求内容和返回结果、示例代码的自动生成。
请求说明
请求示例
HTTP 方法: POST
请求URL: https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2
URL参数:
| 参数 | 值 |
|---|---|
| access_token | 通过API Key和Secret Key获取的access_token,参考“Access Token获取” |
Header如下:
| 参数 | 值 |
|---|---|
| Content-Type | application/x-www-form-urlencoded |
Body中放置请求参数,参数详情如下:
请求参数
| 参数 | 类型 | 是否必须 | 说明 |
|---|---|---|---|
| image | string | 和 url/pdf_file 三选一 | 图像数据,base64编码后进行urlencode,要求base64编码和urlencode后大小不超过4M,最短边至少15px,最长边最大4096px,支持jpg/jpeg/png/bmp格式 优先级:image > url > pdf_file,当image字段存在时,url、pdf_file字段失效 |
| url | string | 和 image/pdf_file 三选一 | 图片完整url,url长度不超过1024字节,url对应的图片base64编码后大小不超过4M,最短边至少15px,最长边最大4096px,支持jpg/jpeg/png/bmp格式 优先级:image > url > pdf_file,当image字段存在时,url字段失效 请注意关闭URL防盗链 |
| pdf_file | string | 和 image/url 三选一 | PDF文件,base64编码后进行urlencode,要求base64编码和urlencode后大小不超过4M,最短边至少15px,最长边最大4096px 优先级:image > url > pdf_file,当image、url字段存在时,pdf_file字段失效 |
| pdf_file_num | string | 否 | 需要识别的PDF文件的对应页码,当 pdf_file 参数有效时,识别传入页码的对应页面内容,若不传入,则默认识别第 1 页 |
| enable_detect | string | 否 | 是否去除文件边缘后再识别,默认为 true,可选值: - true:去除,适用于有背景/边缘的拍摄件 - false:不去除,适用于不含背景/边缘的扫描件 |
| enable_ori | int32 | 否 | 选择是否开启图像方向转正功能,可选值如下: - enable_ori=0,默认值,不开启转正; - enable_ori=1,开启转正 |
返回说明
返回参数
| 参数 | 类型 | 是否必须 | 说明 |
|---|---|---|---|
| log_id | uint64 | 是 | 唯一的log id,用于问题定位 |
| image_processed | string | 是 | 返回处理后的图片,base64编码 |
| pdf_file_size | string | 否 | 传入PDF文件的总页数,当 pdf_file 参数有效时返回该字段 |
返回示例
JSON
1{
2    "image_processed": "/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAAYEBQYFB",
3    "log_id": 1540571996316633631
4}
评价此篇文章